
Статья Дмитрия Красникова, руководителя направления Big Data & BI в К2Тех
Сегодня почти все компании в России инвестируют в ИИ. По данным Apple Hills Digital, Selectel, Cloud.ru и VK Tech, 65% российских компаний увеличили ИТ-бюджеты на 2026 год, и главный приоритет инвестиций — ИИ. Рынок систем управления данными в 2025 году достиг 102 млрд ₽ (+13,9%), а ключевым трендом стал GenAI в работе с данными. По оценке К2Тех, 20,3% компаний уже имеют полностью подготовленные и размеченные датасеты для ИИ. Еще 42,6% сейчас очищают и консолидируют данные.
Большинство компаний уже умеют подключать большие языковые модели (LLM, модели вроде ChatGPT) к корпоративным системам, настраивать RAG (поиск данных перед ответом), разграничивать доступы и защищать чувствительную информацию. Но в корпоративной среде модель часто дает технически верные ответы, которые нельзя использовать в работе. Проблема начинается на стыке сервис-доступа к данным и LLM: модель находит технически правдоподобную информацию, но не всегда понимает ее бизнес-смысл, связь с другими объектами и актуальность. Таким образом, пользователь получает не до конца достоверную информацию, что влияет на ее дальнейшее использование и принятие бизнес-решений.
Корпоративная модель данных (КМД) может стать навигатором, который направляет ИИ не к ближайшему видимому фрагменту информации, а к полному, проверенному и подходящему набору данных для конкретных бизнес-задач.
Классическая дата-платформа
Если посмотреть на нее на верхнем уровне, без ИИ, картина знакомая. Слева находятся источники, структурированные и неструктурированные. Данные из них собирают, обрабатывают и кладут в хранилище. Вокруг выстроен Data Governance: правила, бизнес-контекст, каталог и глоссарий, метаданные и lineage (происхождение данных), контроль качества (DQ), MDM (единые справочники). Рядом работает контур информационной безопасности.
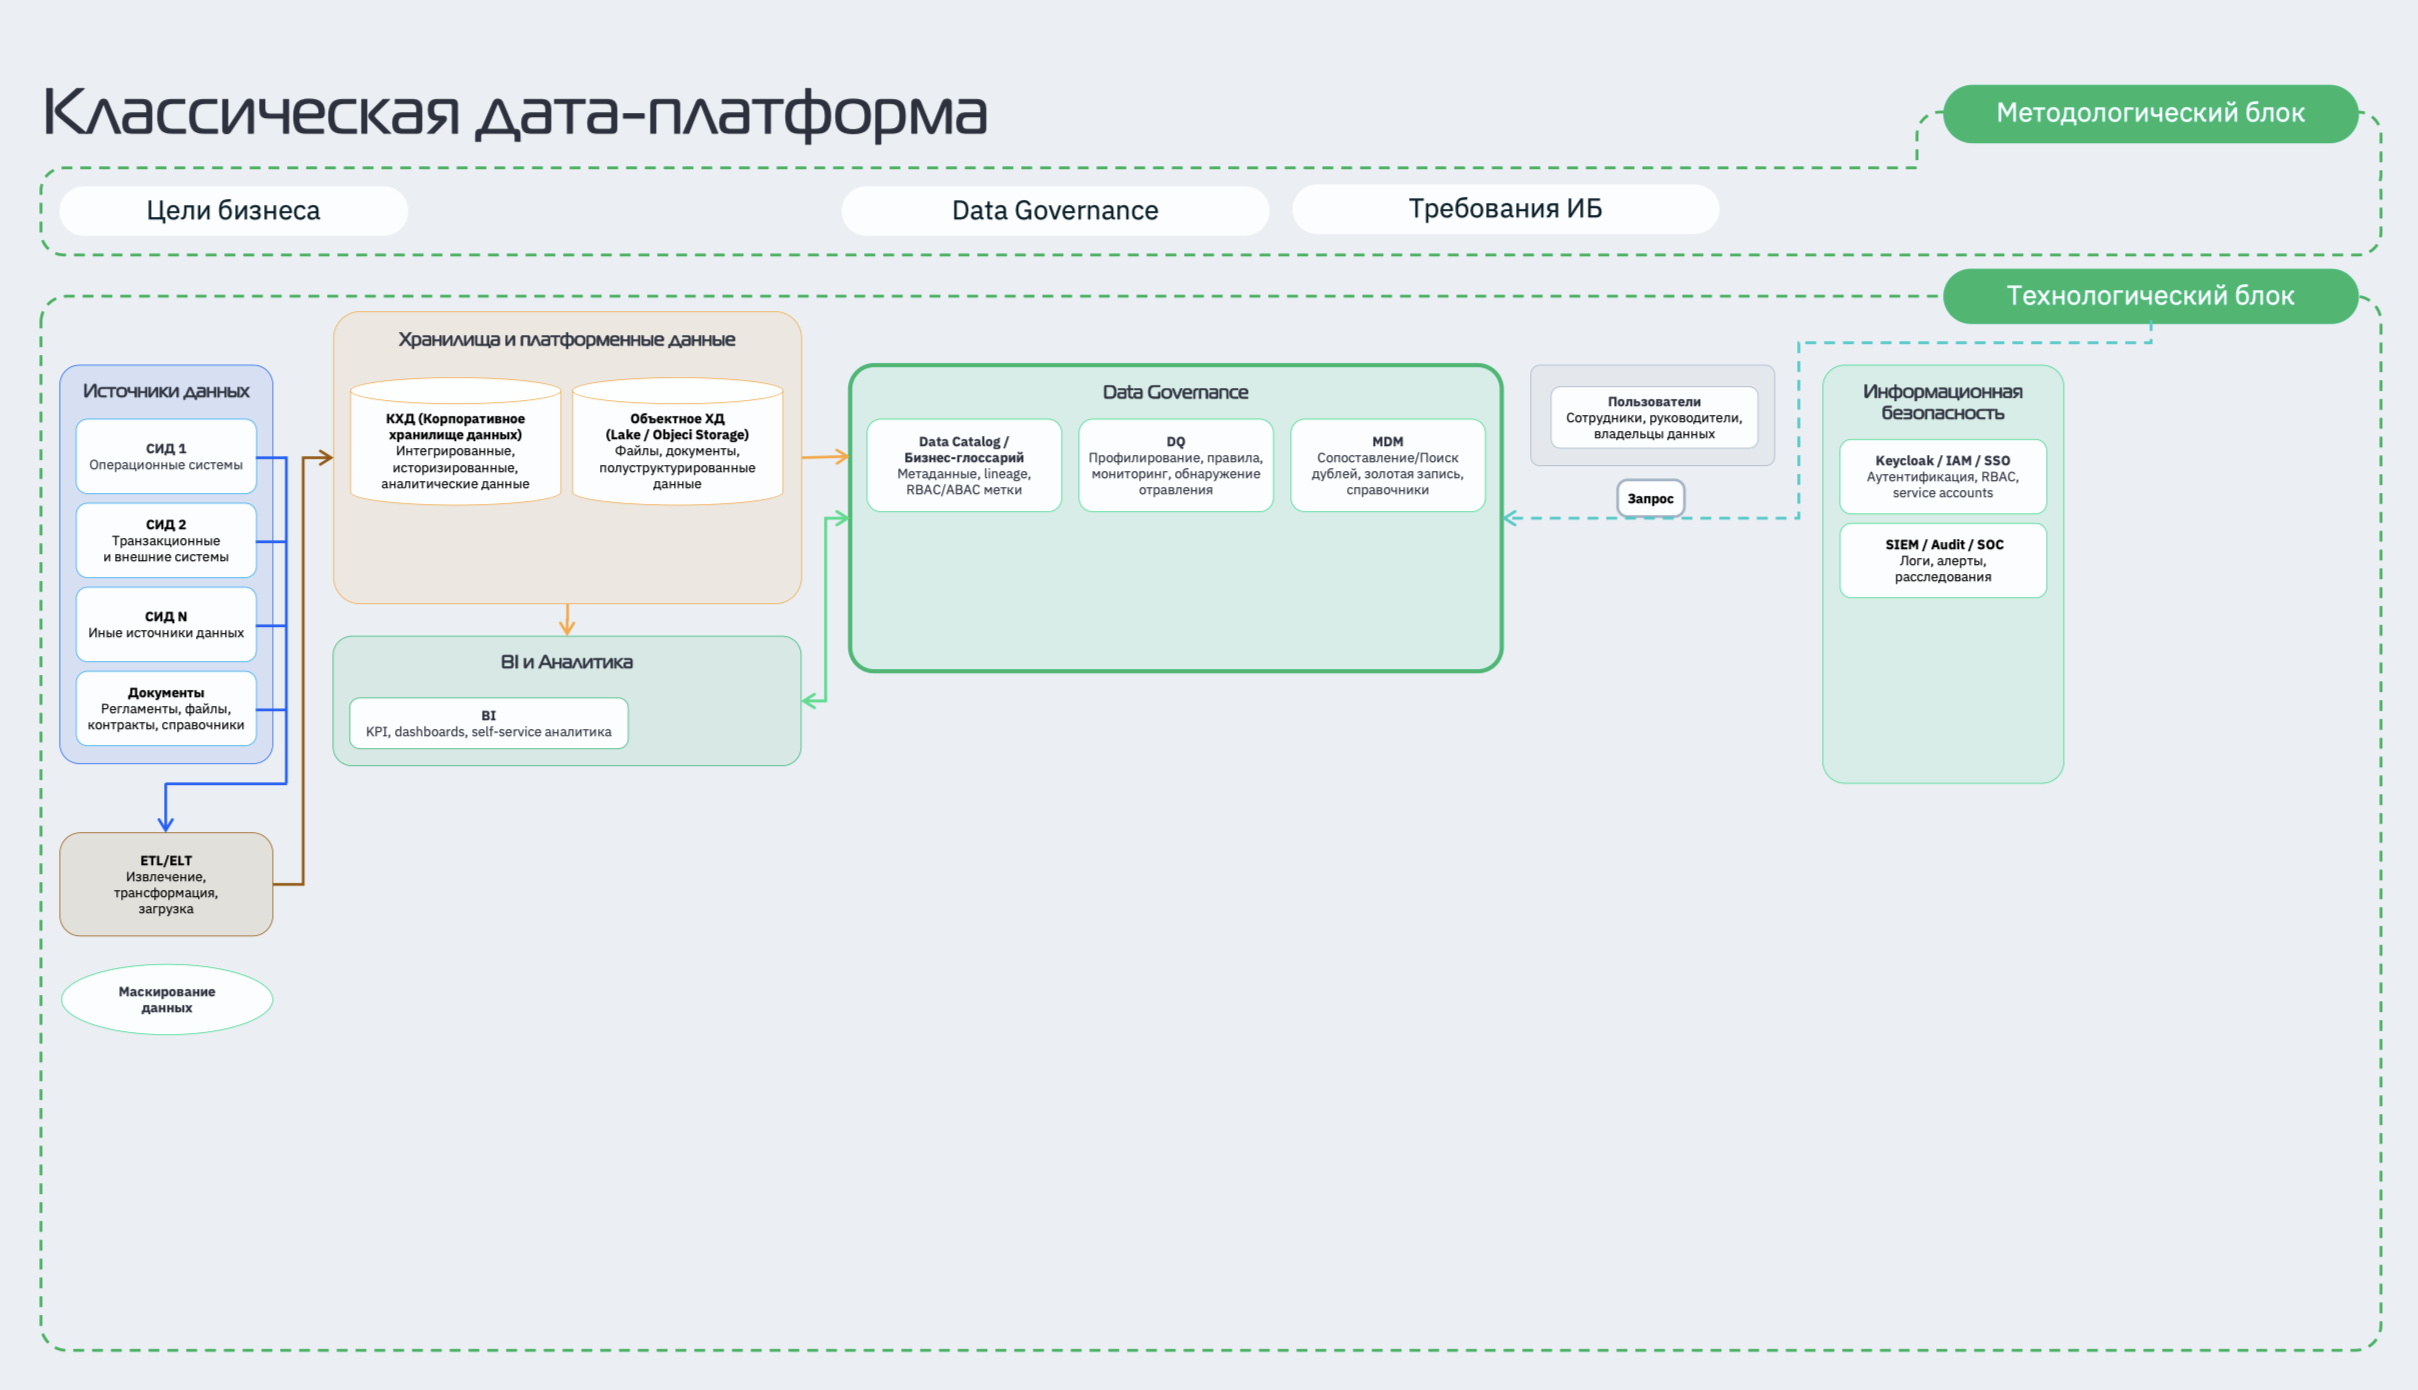
В этой схеме есть важная деталь — навигация, то есть понимание, куда идти за нужными данными. Обычно в компании есть команда, которая прошла весь путь данных от источников до целевых показателей и знает все нюансы. Эти знания, как правило, остаются либо в алгоритмах и в том, что описано в Data Governance, либо в головах архитекторов, аналитиков и разработчиков. Пока с данными работают люди, человек сам знает, куда идти за нужной информацией.
Что меняется с появлением ИИ
Когда в архитектуру встраивают искусственный интеллект, меняется ИТ-ландшафт и добавляется технический стенд. В каждом компоненте появляются отдельные ИИ-агенты: один следит за описаниями и качеством данных, второй — проверяет, не устарели ли они, третий — убирает дубли в справочниках, четвертый — собирает отчеты и дашборды. Строятся новые коннекторы, векторные базы данных и RAG-архитектура. Появляется LLM-шлюз с маршрутизацией по корпоративной политике. Есть требования к ИБ: маскирование, разграничение доступа к агентам, проверка PII (персональных данных) и DLP (защиты от утечек), защита от промпт-инъекций (команд, которые пытаются обмануть ИИ).
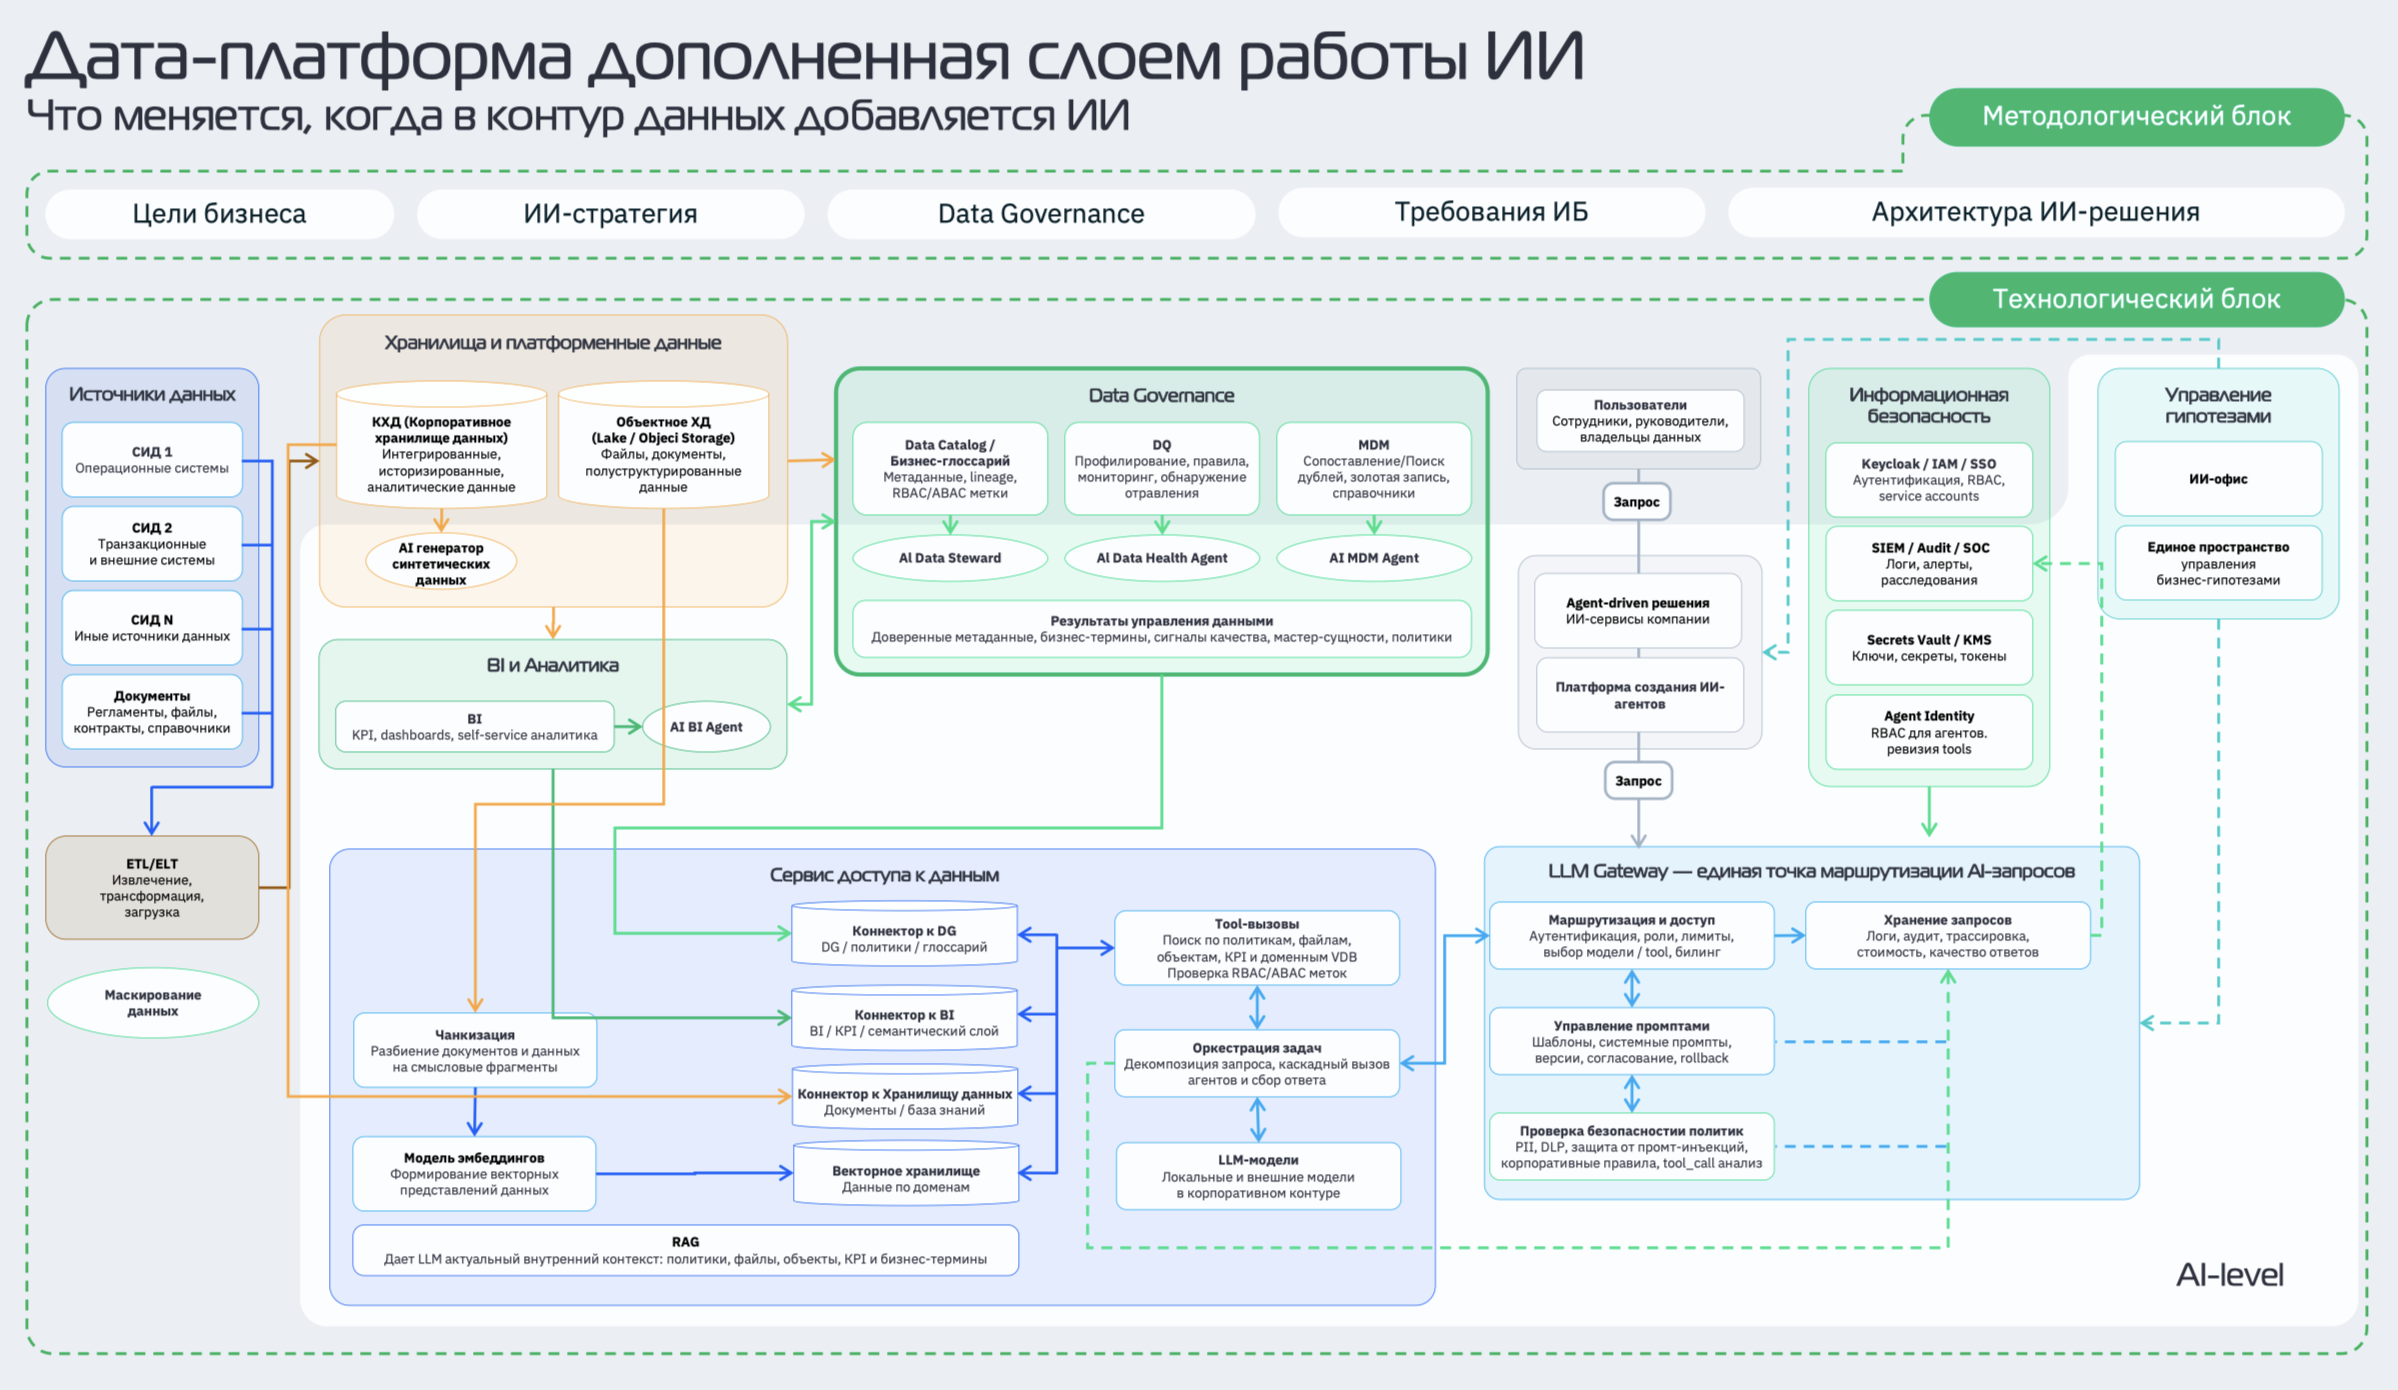
На первый взгляд кажется, что все продумано, но при использовании ИИ в корпоративной среде эффект не достигается. Причина — архитектурный нюанс, малозаметная деталь, которая мешает получить ожидаемый результат. Она возникает на стыке между сервисом доступа к данным и языковой моделью. Мы дали ИИ доступ к данным, но дали ли мы ему навигацию?
Поиск релевантного опыта
Можно проиллюстрировать проблему на примере К2Тех: у нас ежегодно реализуется более тысячи проектов. Например, под критерии тендера нужно подобрать релевантный опыт внедрения ИИ в промышленности и подать конкурсную документацию. Опыт разбросан по многим системам: хранится в проектной базе, базе знаний, CRM, базе договоров.
Агент отвечает на запрос и анализирует данные из разных систем. Ответ может прийти из одной системы или из нескольких, и он каждый раз разный:
- База знаний нашла 46 кейсов. Ключевой проект — «Предиктивная аналитика для нефтегазовой компании — имеет статус «внедрено», но номера у него нет, а вместо акта указано «см. проектную папку».
- CRM нашла 27 сделок. Сделка D-5531 в статусе «выиграна», но данных об архитектуре и акте нет.
- Проектная база нашла 12 проектов. Проект PRJ-2291 закрыт, известны архитектура и команда, есть ссылка на акт.
- Договоры/ЭДО нашли 3 договора. Акт № 14 подписан, но архитектуры и команды в данных нет.
Формально ответ технически корректен, но использовать его нельзя. Сотрудник вынужден перепроверять то, что нашел ИИ, и тратит время вместо того, чтобы его сэкономить. Если задать вопрос повторно, ответ получится другим, и эта вариативность мешает работе.
Возникает закономерный вопрос: разве Data Governance не создан для формирования бизнес-контекста? Создан, и без него внедрение ИИ невозможно в принципе — это гигиенический базовый минимум для любой компании. Но управление данными описывает данные, а не предлагает путь к нужной системе и нужным данным и не консолидирует ответ.
Три барьера, которые ослепляют ИИ
Без корпоративной модели данных ИИ-решения остаются «слепыми», и этому есть три причины.
Семантический разрыв. Data Governance чаще всего строится на доменах, которые в лучшем случае связаны между собой, а иногда и нет. Бизнес просит «выручку», а в базах лежит sales_amt. Оборудование финансового департамента со своими свойствами — не то же самое, что оборудование в домене производства, и на уровне карточек объектов связи между ними вообще может не быть.
Непрозрачный след ответа. ИИ выдает результат, но отследить, на каких источниках и данных он основан, невозможно. Цифра есть, но откуда она появилась непонятно, поэтому руководители и аудиторы не могут ее проверить.
Устаревание данных. Сейчас информация описана в Data Governance, а завтра она устарела: источники изменились, данные изменились, изменился процесс, изменилась методология. Источники меняются каждый день, а модель обновляют вручную раз в полгода.
Корпоративная модель данных как навигатор
Решение, которое К2Тех нашел совместно с заказчиком, не новое — это давно забытое старое. Корпоративная модель данных — это живой организм, карта информационной среды компании: движущий, сбалансированный и постоянно меняющийся документ с семантическим ядром и всеми связями внутри организации. Модель обновляется вместе с данными и связывает сущности бизнеса физически с адресами их хранения.
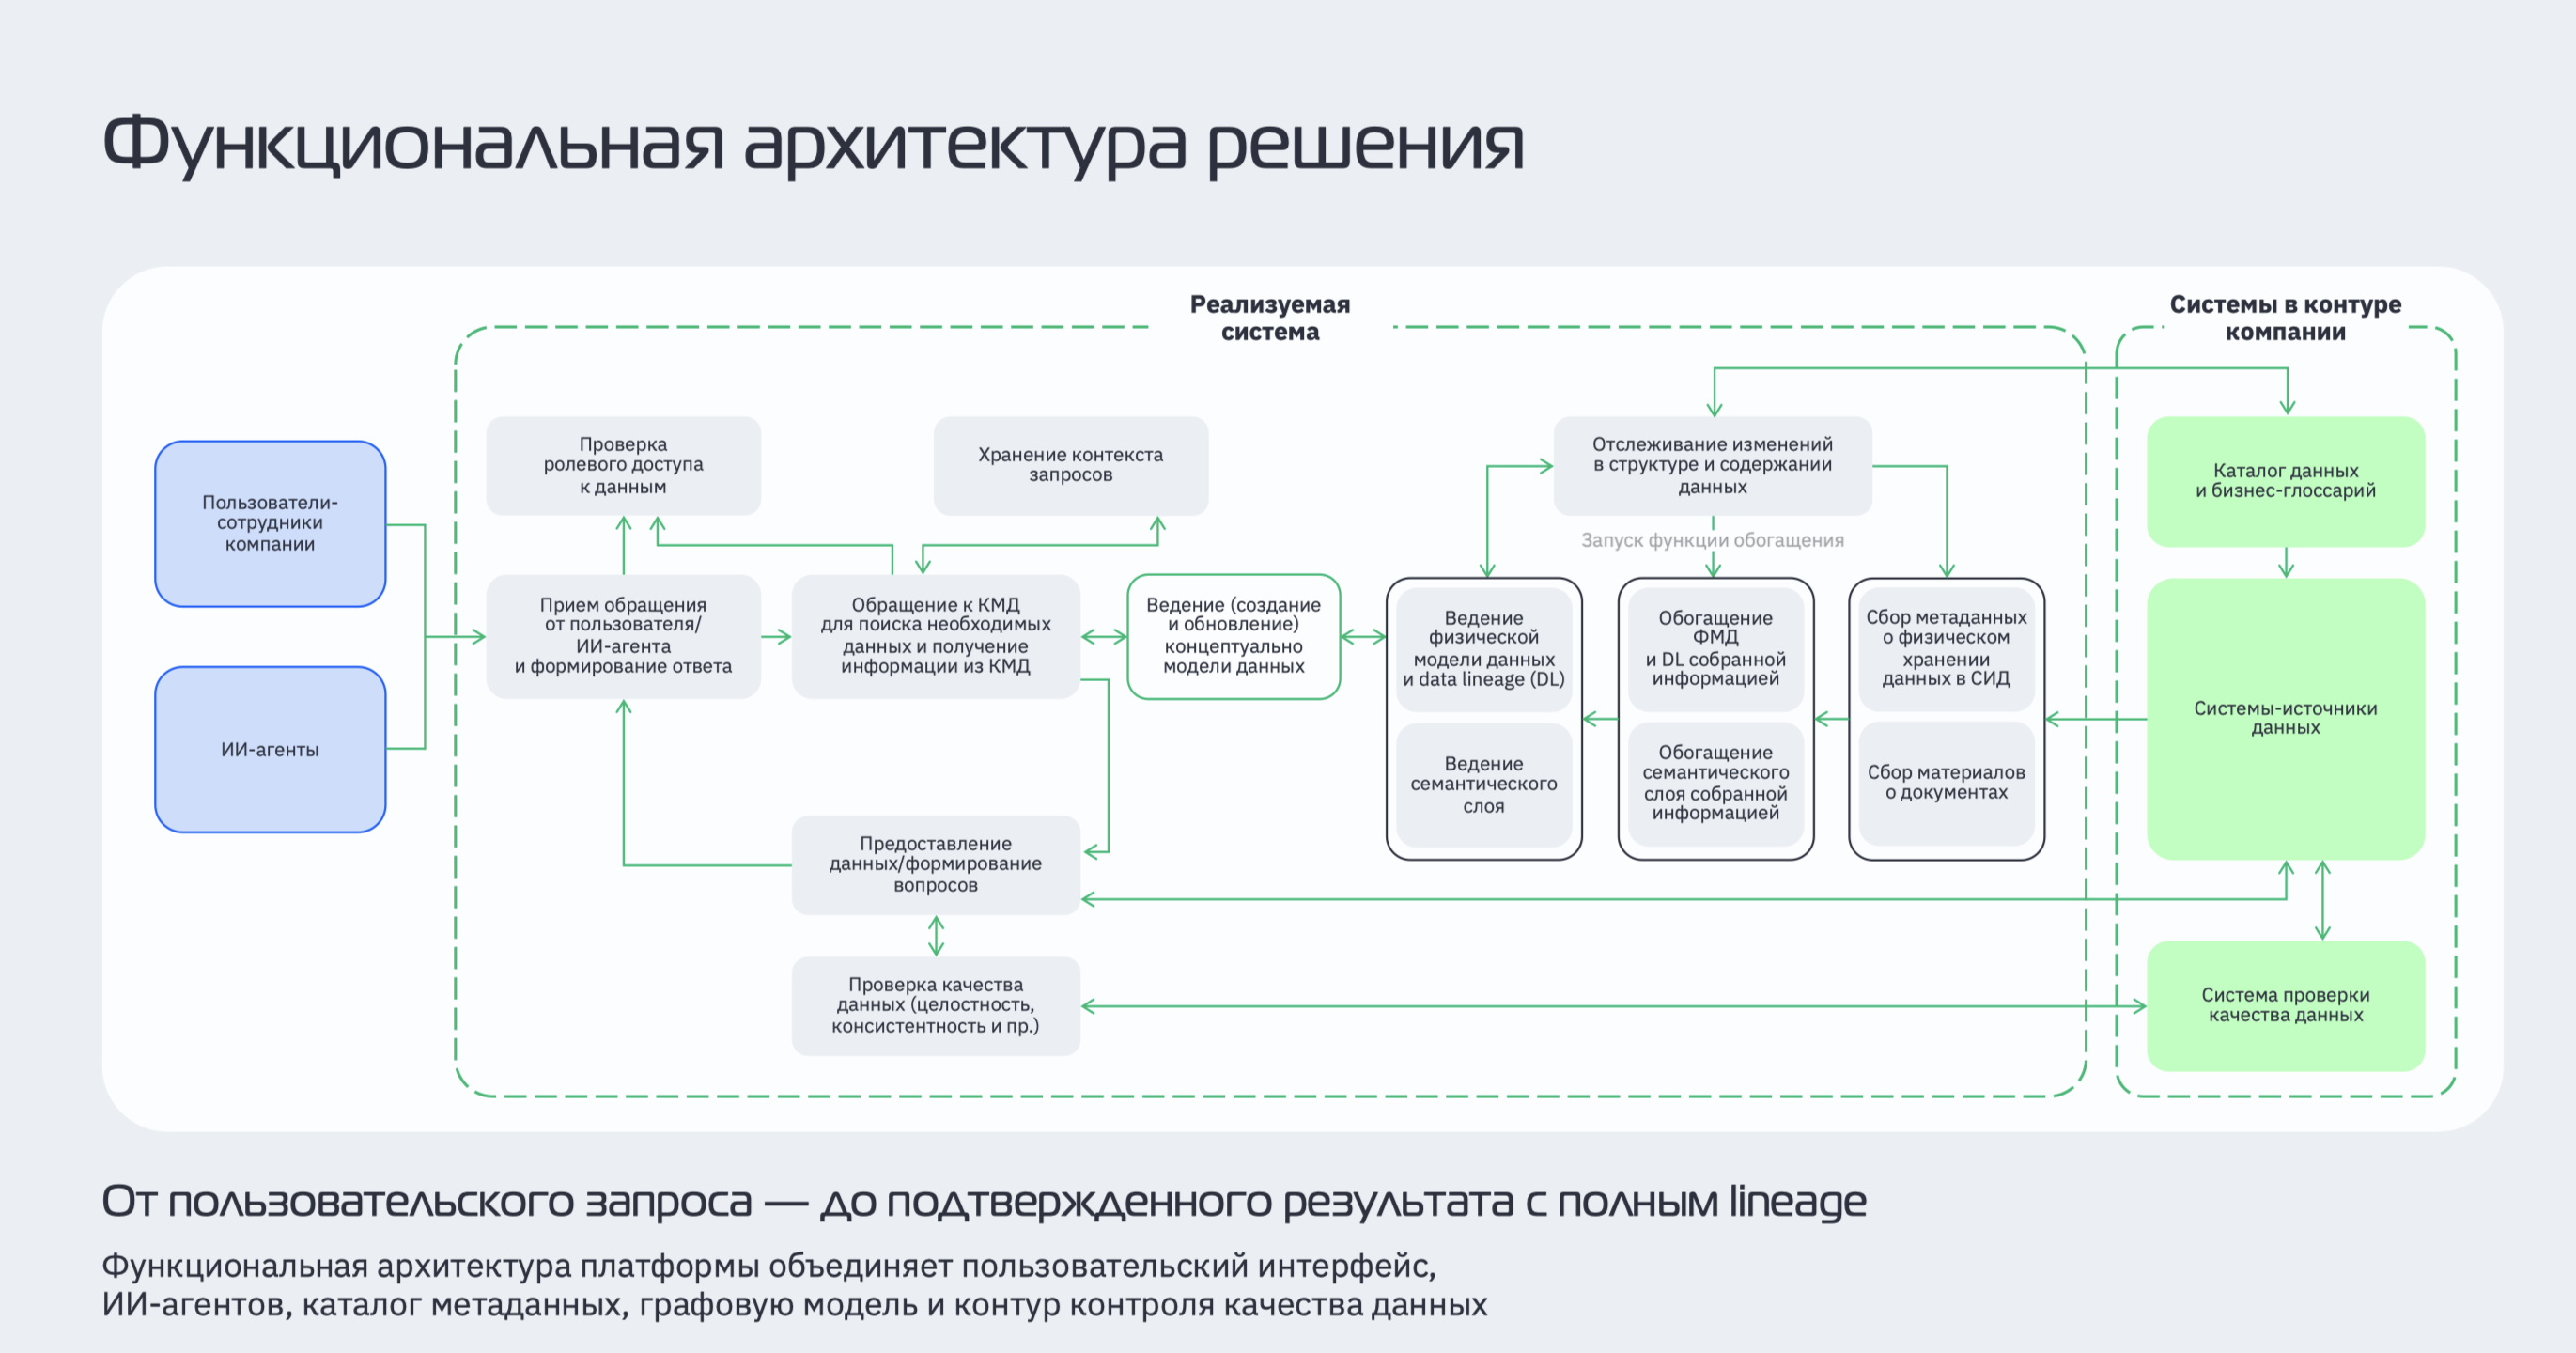
По сути, КМД — это навигатор внутри компании или регулировщик на большом перекрестке, где множество запросов и источников, а кто-то должен направлять запросы по правильным маршрутам.
Функционально в КМД выделяют три блока:
- Получение и сбор информации из систем-источников и документов: построение физических моделей данных, описание и генерация семантики;
- Создание и обновление самой КМД — семантического ядра, связанного с физическим размещением данных;
- Работа с пользователями и агентами.
Для искусственного интеллекта КМД работает как карта: подсказывает, что считать «проектом», как связать записи из CRM, ERP и проектной базы и в каком источнике идти за ответом. ИИ получает не готовый набор похожих фрагментов, а маршрут к нужным данным.
Как КМД снимает барьеры
Если установить КМД в узком месте между сервисом доступа к данным и языковой моделью, тот же тендерный запрос обрабатывается иначе. Агент получает запрос и правильную навигацию до правильных данных в правильных источниках. Семантика включает записи, проверки качества данных, подтверждающие результат.
Итоговый ответ выглядит примерно так: проверено 88 записей из 5 систем, замечено 7 проектов, из них 3 соответствуют критериям тендера. Для каждого приведите договор, акты со ссылками на сканы, архитектуру и команду. Так, для PRJ-2291 указана архитектура OPC UA → Kafka → ClickHouse → ML-модели → 1С:ТОИР, договор 24-117/ИТ и акты № 14 и № 19. Четыре проекта исключены с объяснением причины: только КП, пилот без акта, не промышленность, вне срока. Такой ответ можно приложить к любой документации и отправить в тендер.
Главный эффект — снижение вариативности ответов: задача в том, чтобы свести варианты к нулю и получать максимально точный и проверенный ответ. Вместо четырех противоречивых ответов приходит один, у каждой цифры виден источник, а аналитикам не нужно сверять выгрузки вручную.
От теории к практике
Большинство «кубиков» архитектуры мы уже опробовали в трех направлениях.
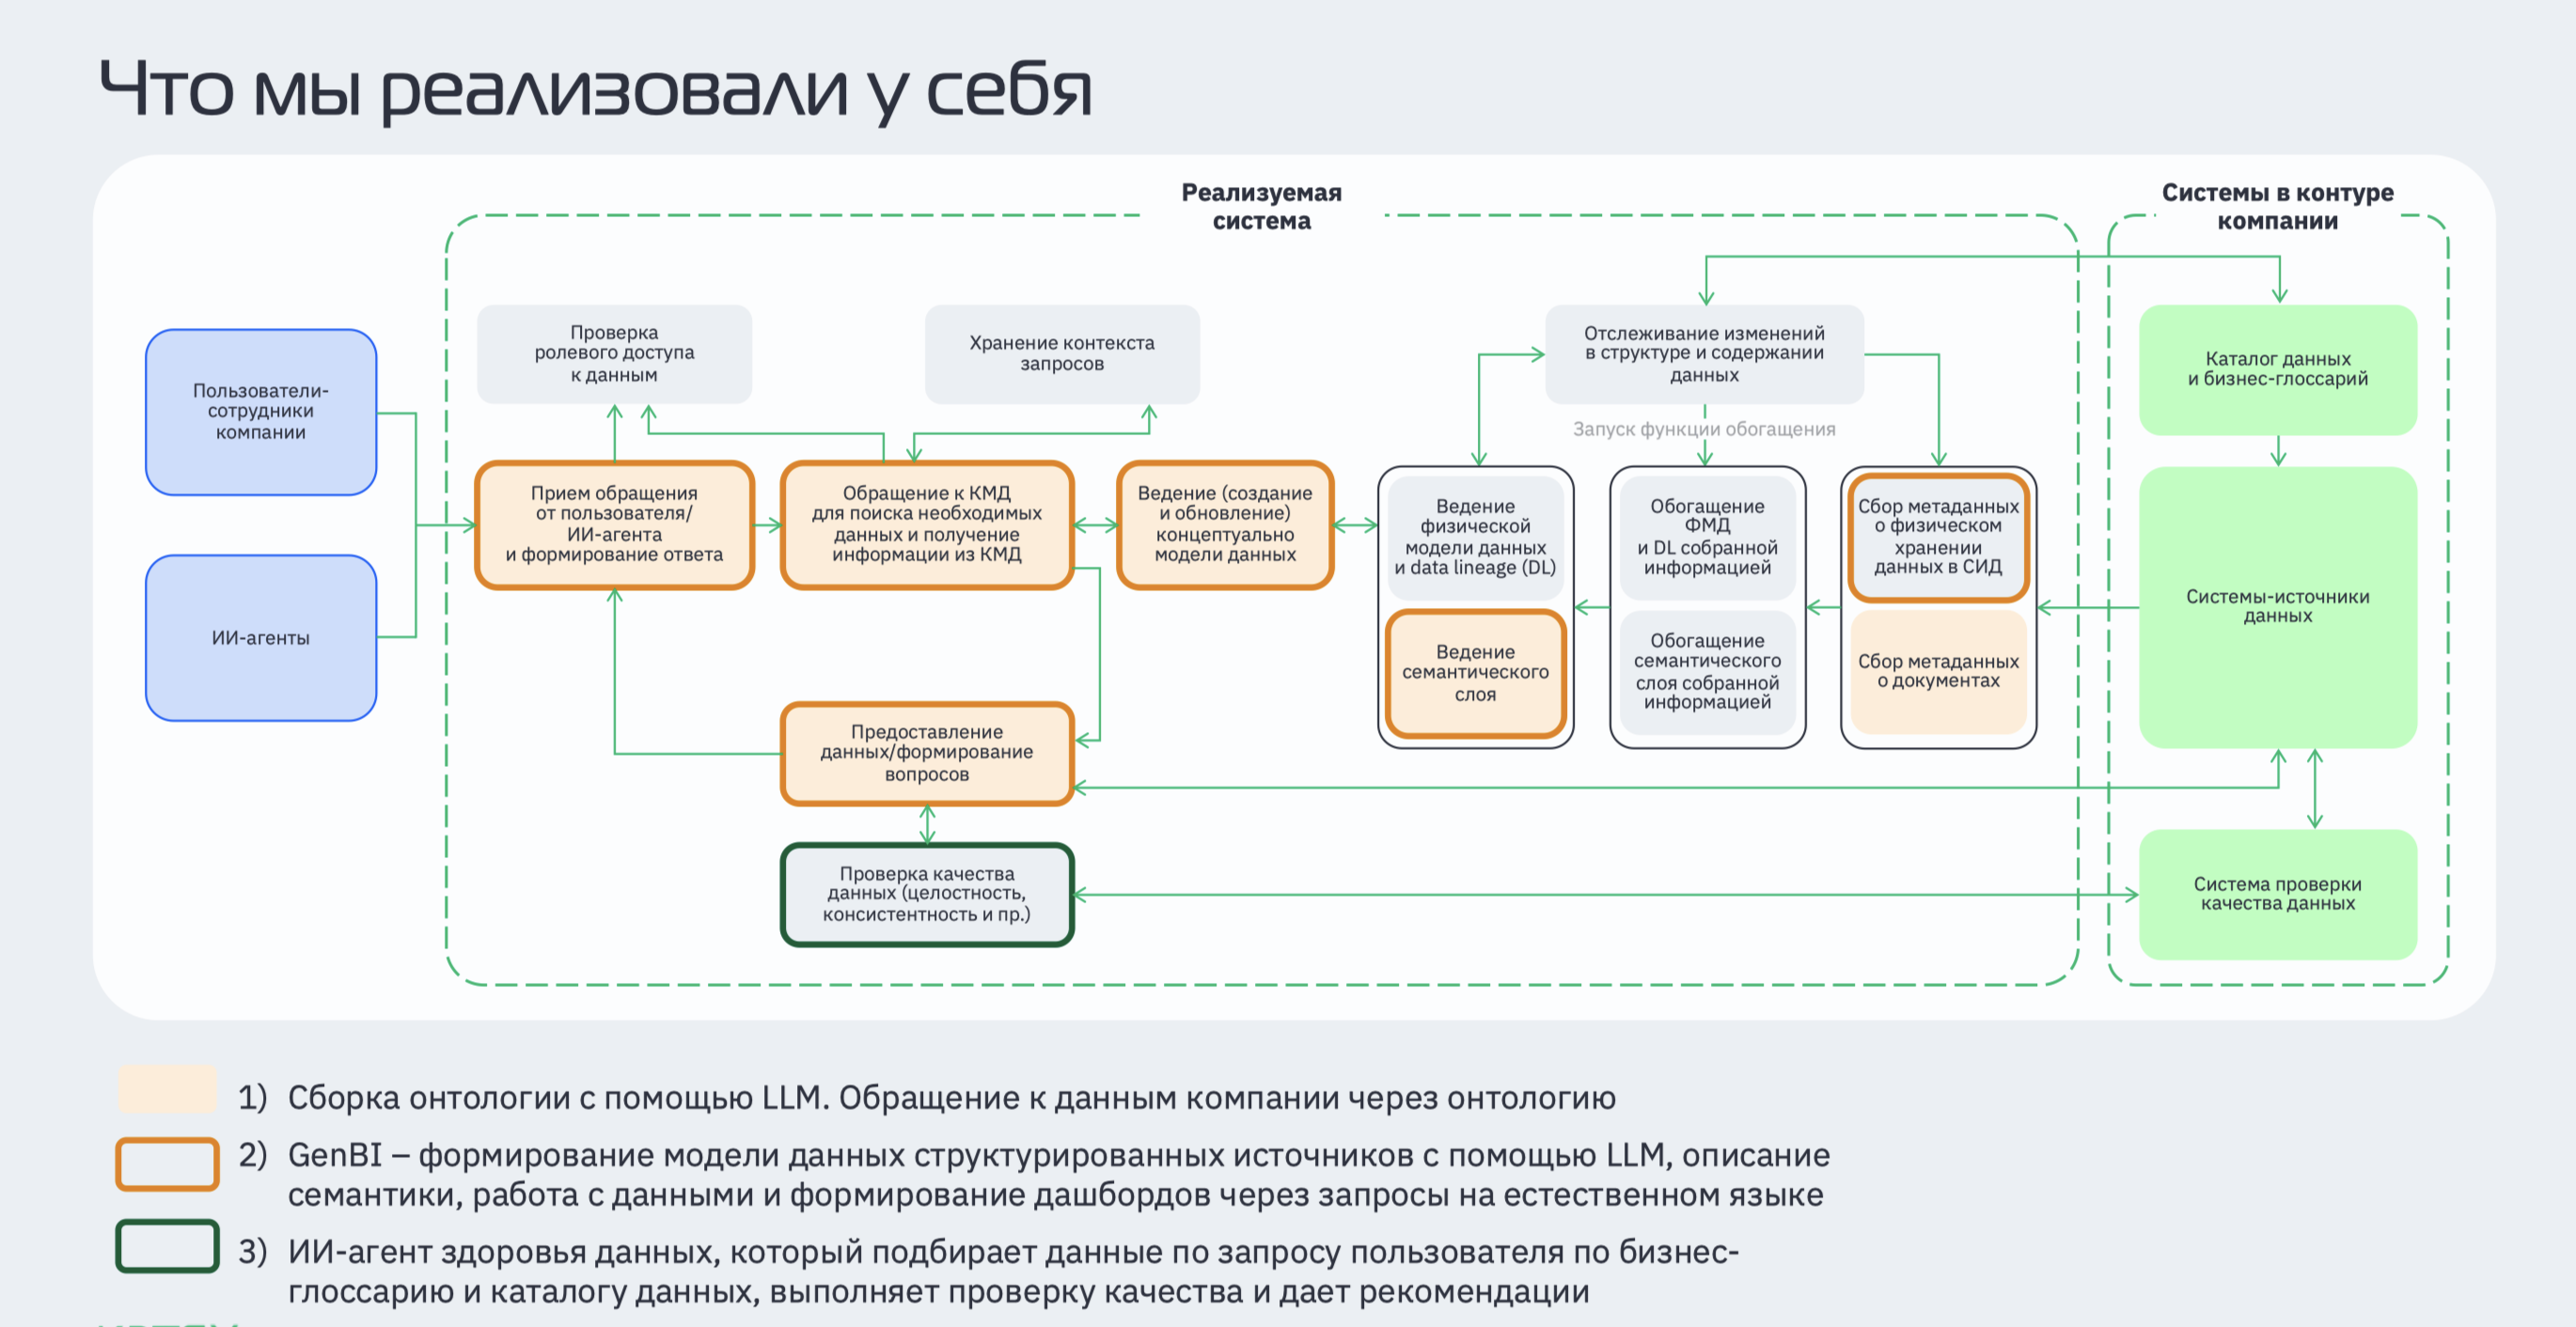
- Сборка онтологии с помощью LLM. Применен онтологический графический подход: модель строит онтологию, и через нее можно обращаться к данным компании.
- GenBI. Изначально мы создавали КМД для себя, но затем создали продукт, не завязанный на существующую систему. Он сканирует физические модели данных из разных источников, объединяет их по смыслу и связывает с реальным расположением данных на месте. В ответ на аналитический вопрос пользователь получает готовую витрину с расчетными показателями и дашборд, который можно параметризировать и разместить в своем портале.
- ИИ-агент здоровья данных. Агент работает на базе Data Governance и каталога данных. Пользователь задает вопрос или проверяет гипотезу, а система показывает, какие данные в компании относятся к теме, соответствуют ли они требованиям к качеству, и дает рекомендации по работе с ними до проверки гипотезы.Эти элементы решают проблему навигации ИИ-агента по отдельности или в совокупности.
Вопросы, которые звучат чаще всего
Почему недостаточно RAG? RAG-архитектура не учитывает большую вариативность: обычно она ищет наиболее короткий путь к схожим данным и может получить ответ только из одного источника.
Встроить на платформу или держать рядом? КМД должна быть встроена в платформу. Два блока, стоящие рядом друг с другом, для этой задачи не подходят.
Как загрузить бизнес-контекст, который живет в головах сотрудников? Базовый минимум — Data Governance как фундамент, где хотя бы данные описаны. RAG сам по себе не снимает проблему вариативности: он ищет кратчайший путь к похожим данным и может брать ответ из одного источника. На Западе уже есть решения, которые строят онтологические модели и КМД поверх Data Governance. Это не отдельная сущность, а надстройка над ним для понятного бизнес-контекста.
Можно ли доверять ИИ, который строит КМД? Без участия человека не обойтись: результат нужно верифицировать. Но это все равно менее затратно, чем строить модель с нуля вручную.
Как измерять качество? Помимо качества собственных данных, необходимо проверить качество ответа ИИ. Для этого используется специальный сервис проверок на соответствие бизнес-правилам.
В заключение
Еще недавно на рынке был тренд на AI Governance, Data Governance и качество ИИ-системы в целом. Но сегодня бизнесу в первую очередь нужны качественные, размеченные и структурированные данные, чтобы эффективно использовать ИИ. Компании уже очистили и структурировали данные, а некоторые уже запускают первые пилотные проекты. Data Governance остается неизменным фундаментом внедрения ИИ. Однако чтобы ИИ приносил максимальную пользу бизнесу, необходимо выстраивать динамический навигационный слой, который направляет ИИ к полному, единственному и правильному ответу — КМД.
Корпоративная модель данных берет на себя ту навигацию, которая раньше держалась на командах, помнящих весь путь данных от источника до показателя. Знания уходят от руководителей, архитекторов и аналитиков к живой, обновляемой модели, которую можно проверять, внедрять и передавать. Для бизнеса это означает меньше затрачиваемого времени на перепроверку ответов ИИ и отслеживание каждой цифры.


